English · PDF 374
此图中有 250 个模型,但其中很多都非常糟糕!我们需要通过精确化我们的直觉——即好的模型与数据“接近”——来找到好的模型。我们需要一种方法来量化数据与模型之间的距离。然后,我们可以通过找到使模型与该数据距离最小的 a_0 和 a_1 的值来拟合模型。
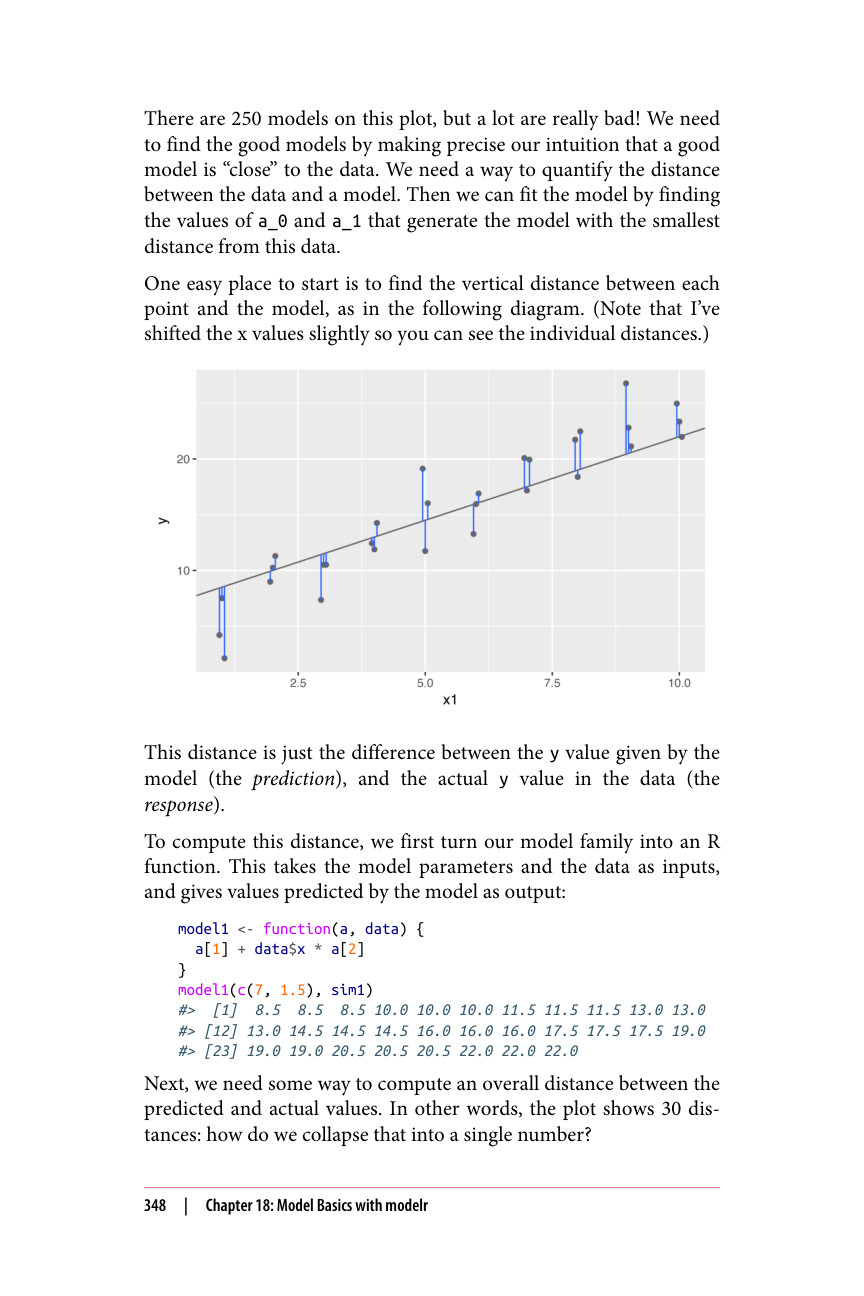
一个简单的切入点是求出每个点与模型之间的垂直距离,如下图所示。(注意,我对 x 值做了轻微偏移,以便你能看到各个距离。)
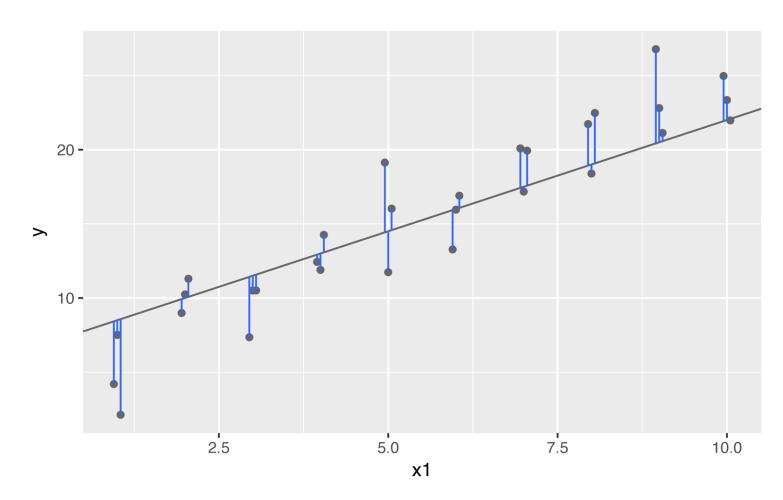
这个距离就是模型给出的 y 值(即预测值)与数据中实际的 y 值(即响应值)之间的差。
要计算这个距离,我们首先将模型族转换为一个 R 函数。该函数以模型参数和数据作为输入,并输出模型预测的值:
model1 <- function(a, data) { a[1] + data$x * a[2] } model1(c(7, 1.5), sim1) #> [1] 8.5 8.5 8.5 10.0 10.0 10.0 11.5 11.5 11.5 13.0 13.0 #> [12] 13.0 14.5 14.5 14.5 16.0 16.0 16.0 17.5 17.5 17.5 19.0 #> [23] 19.0 19.0 20.5 20.5 20.5 22.0 22.0 22.0
接下来,我们需要某种方法来计算预测值与实际值之间的总体距离。换句话说,图中显示了 30 个距离:我们如何将它们汇总为一个单一的数字?