English · PDF 187
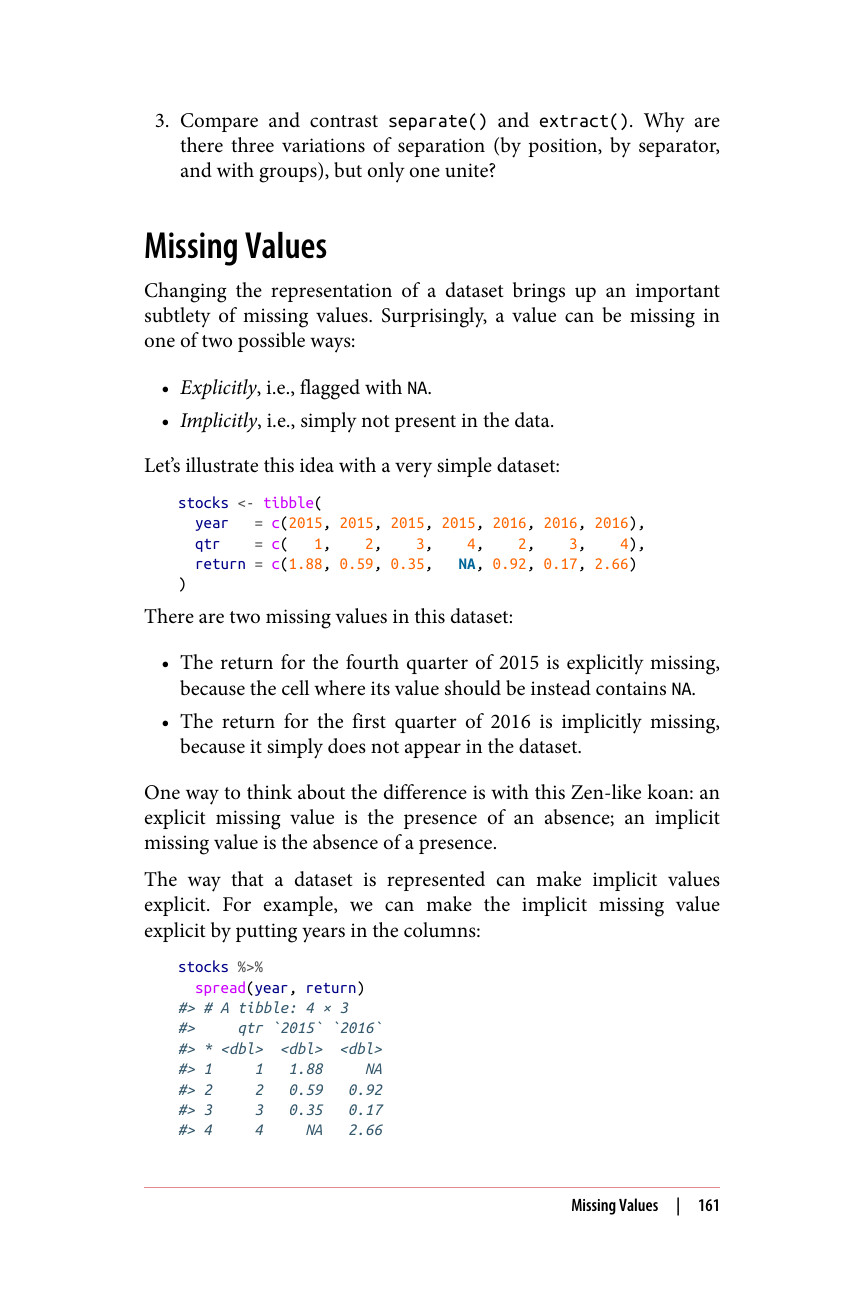
改变数据集的表示方式会引出缺失值的一个重要细节。令人惊讶的是,值可以以两种可能的方式缺失:
让我们用一个非常简单的数据集来说明这个概念:
stocks <- tibble( year = c(2015, 2015, 2015, 2015, 2016, 2016, 2016), qtr = c( 1, 2, 3, 4, 2, 3, 4), return = c(1.88, 0.59, 0.35, NA, 0.92, 0.17, 2.66) )
这个数据集中有两个缺失值:
理解这种区别的一种方式是借助这个禅宗式的公案:显式缺失值是“缺席的存在”;隐式缺失值是“存在的缺席”。
数据集的表示方式可以使隐式值变为显式值。例如,我们可以把年份放到列中,使隐式缺失值变为显式的:
stocks %>% spread(year, return) #> # A tibble: 4 × 3 #> qtr 2015 2016 #> *