English · PDF 458
阅读 ?knitr::kable 的文档,了解自定义表格的其他方式。如需更深入的自定义,可以考虑 xtable、stargazer、pander、tables 和 ascii 这些包。每个包都提供了一组工具,用于从 R 代码返回格式化的表格。
还有一组丰富的选项可用于控制图片的嵌入方式。你将在第 464 页的“保存你的图形”中学到这些内容。
通常情况下,文档的每次编织(knit)都从完全空白的状态开始。这对可重复性很有好处,因为它确保你已将每个重要的计算都记录在代码中。然而,如果某些计算需要很长时间,这可能会很痛苦。解决方案是 cache = TRUE。设置后,这会将代码块的输出保存到磁盘上一个特殊命名的文件中。在后续运行时,knitr 会检查代码是否发生了变化,如果没有变化,就会复用缓存的结果。
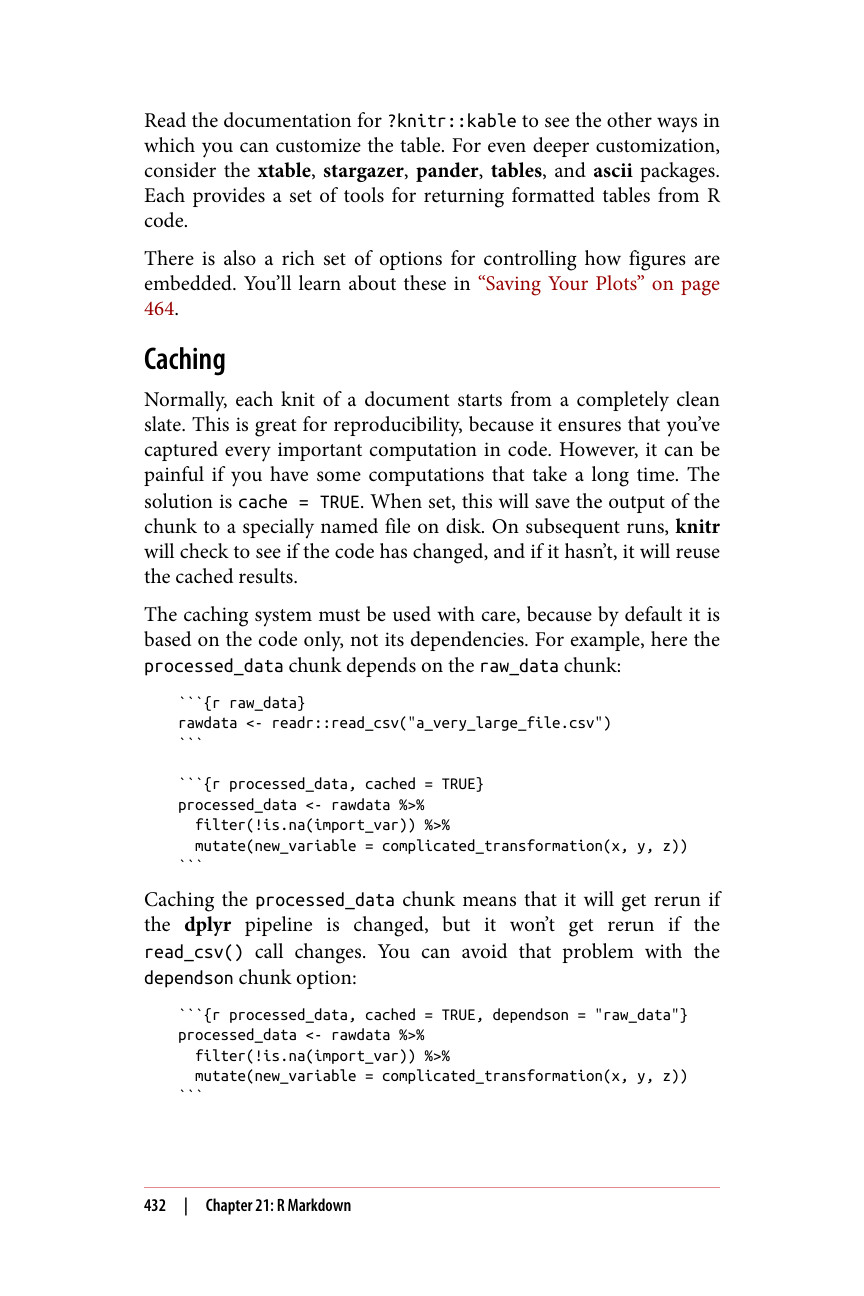
缓存系统必须谨慎使用,因为默认情况下它仅基于代码本身,而不考虑其依赖项。例如,这里 processed_data 代码块依赖于 raw_data 代码块:
{r raw\_data} rawdata <- readr::read\_csv("a\_very\_large\_file.csv") {r processed\_data, cached = TRUE} processed\_data <- rawdata %>% filter(!is.na(import\_var)) %>% mutate(new\_variable = complicated\_transformation(x, y, z))
缓存 processed_data 代码块意味着,如果 dplyr 管道发生了变化,它会被重新运行,但如果 read_csv() 调用发生了变化,它则不会重新运行。你可以使用 dependson 代码块选项来避免这个问题:
{r processed\_data, cached = TRUE, dependson = "raw\_data"} processed\_data <- rawdata %>% filter(!is.na(import\_var)) %>% mutate(new\_variable = complicated\_transformation(x, y, z))