English · PDF 153
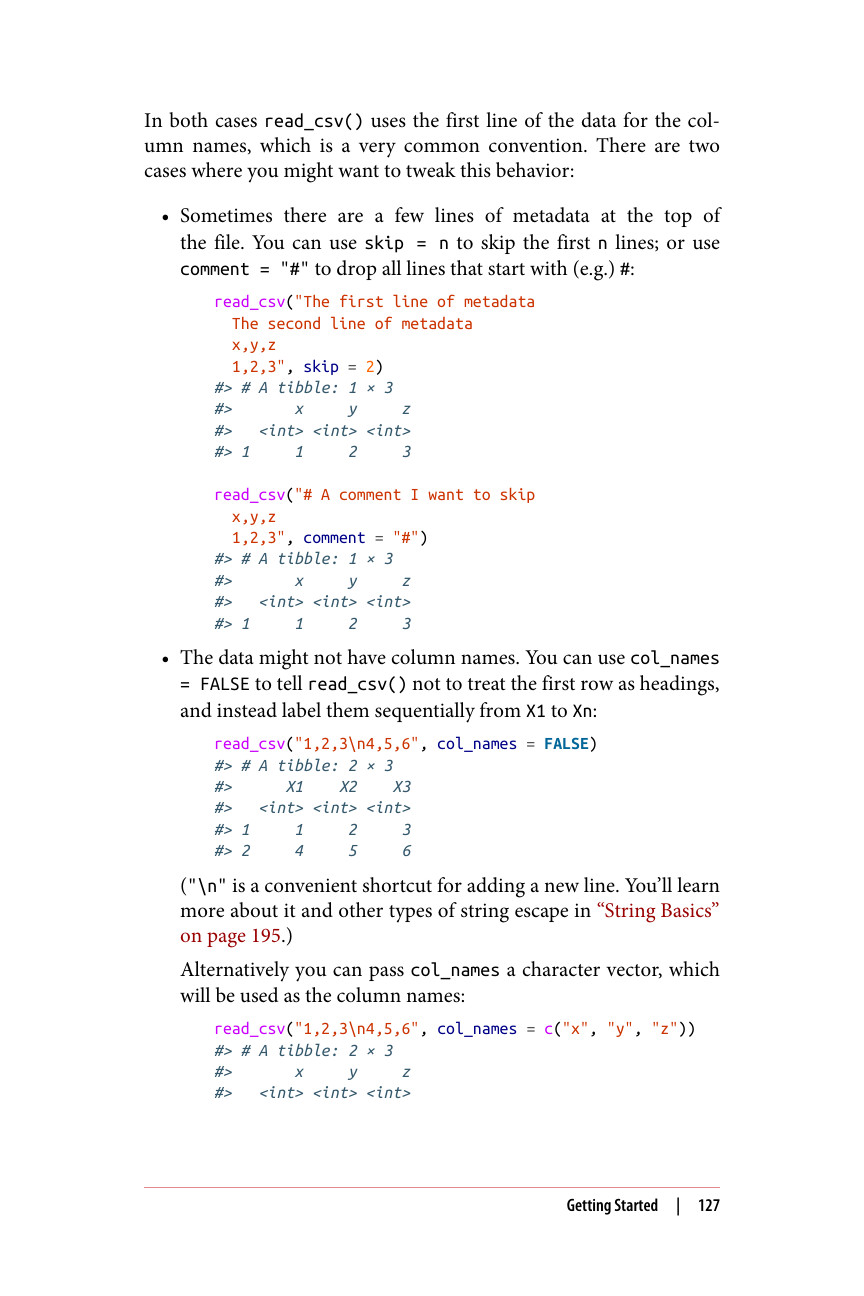
在这两种情况下,read_csv() 都会使用数据的第一行作为列名,这是一种非常常见的约定。有两种情况你可能需要调整这一行为:
read_csv("The first line of metadata The second line of metadata x,y,z 1,2,3", skip = 2) #> # A tibble: 1 × 3 #> x y z #>
read_csv("1,2,3\n4,5,6", col_names = FALSE) #> # A tibble: 2 × 3 #> X1 X2 X3 #>
("\n" 是添加换行符的便捷快捷方式。你将在第 195 页的“字符串基础”中了解更多关于它和其他字符串转义类型的内容。)
或者,你也可以向 col_names 传递一个字符向量,它将被用作列名:
read_csv("1,2,3\n4,5,6", col_names = c("x", "y", "z")) #> # A tibble: 2 × 3 #> x y z #>