English · PDF 93
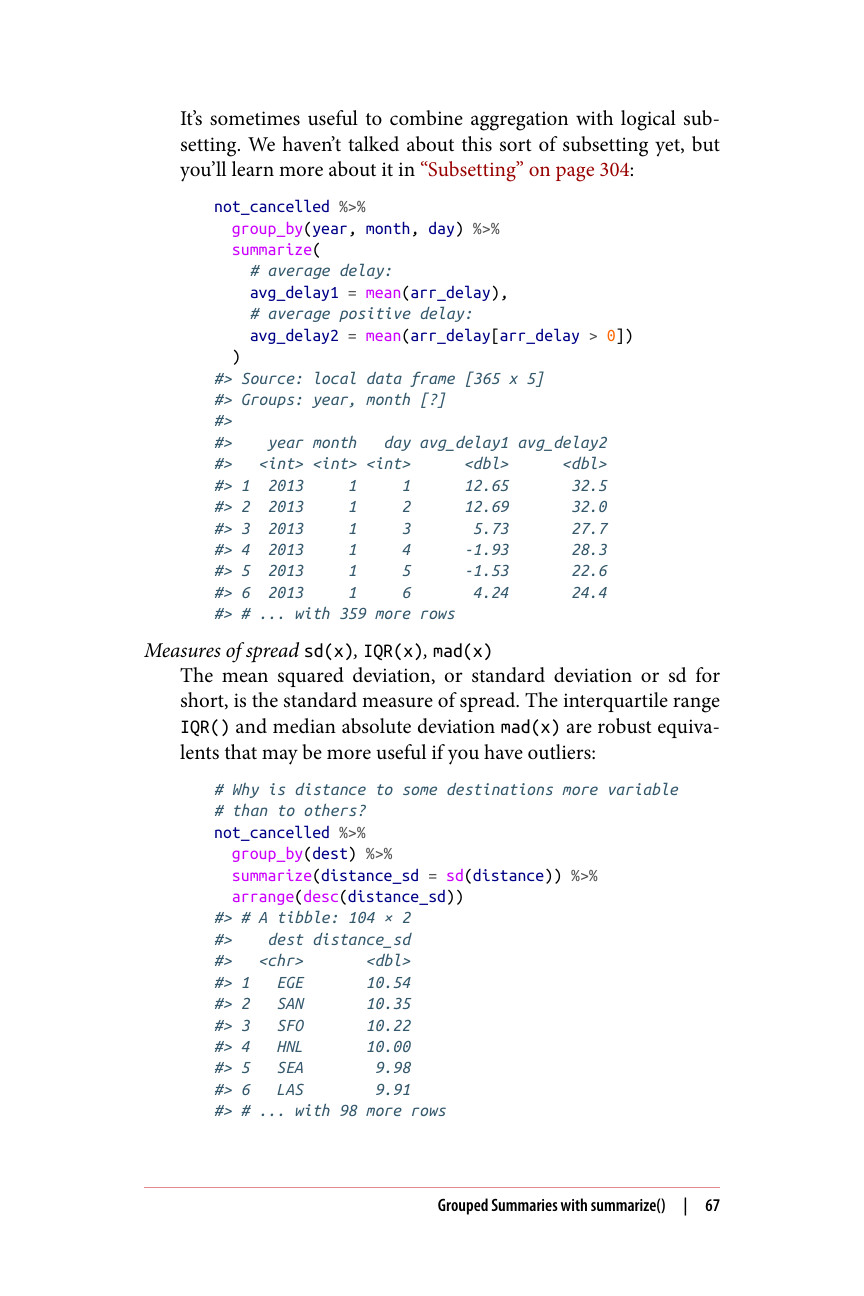
将聚合与逻辑子集结合起来有时很有用。我们还没有讨论过这种子集操作,但你将在第 304 页的“子集”一节中学到更多相关内容:
not_cancelled %>% group_by(year, month, day) %>% summarize( # 平均延误: avg_delay1 = mean(arr_delay), # 平均正延误: avg_delay2 = mean(arr_delay[arr_delay > 0]) ) #> Source: local data frame [365 x 5] #> Groups: year, month [?] #> #> year month day avg_delay1 avg_delay2 #>
均方偏差,或称标准差(standard deviation,简称 sd),是度量离散程度的标准方法。四分位距 IQR() 和中位数绝对偏差 mad(x) 是稳健的等价方法,如果你的数据中存在离群值,它们可能更有用:
# 为什么到某些目的地的距离比到其他目的地的距离 # 变化更大? not_cancelled %>% group_by(dest) %>% summarize(distance_sd = sd(distance)) %>% arrange(desc(distance_sd)) #> # A tibble: 104 × 2 #> dest distance_sd #>