English · PDF 391
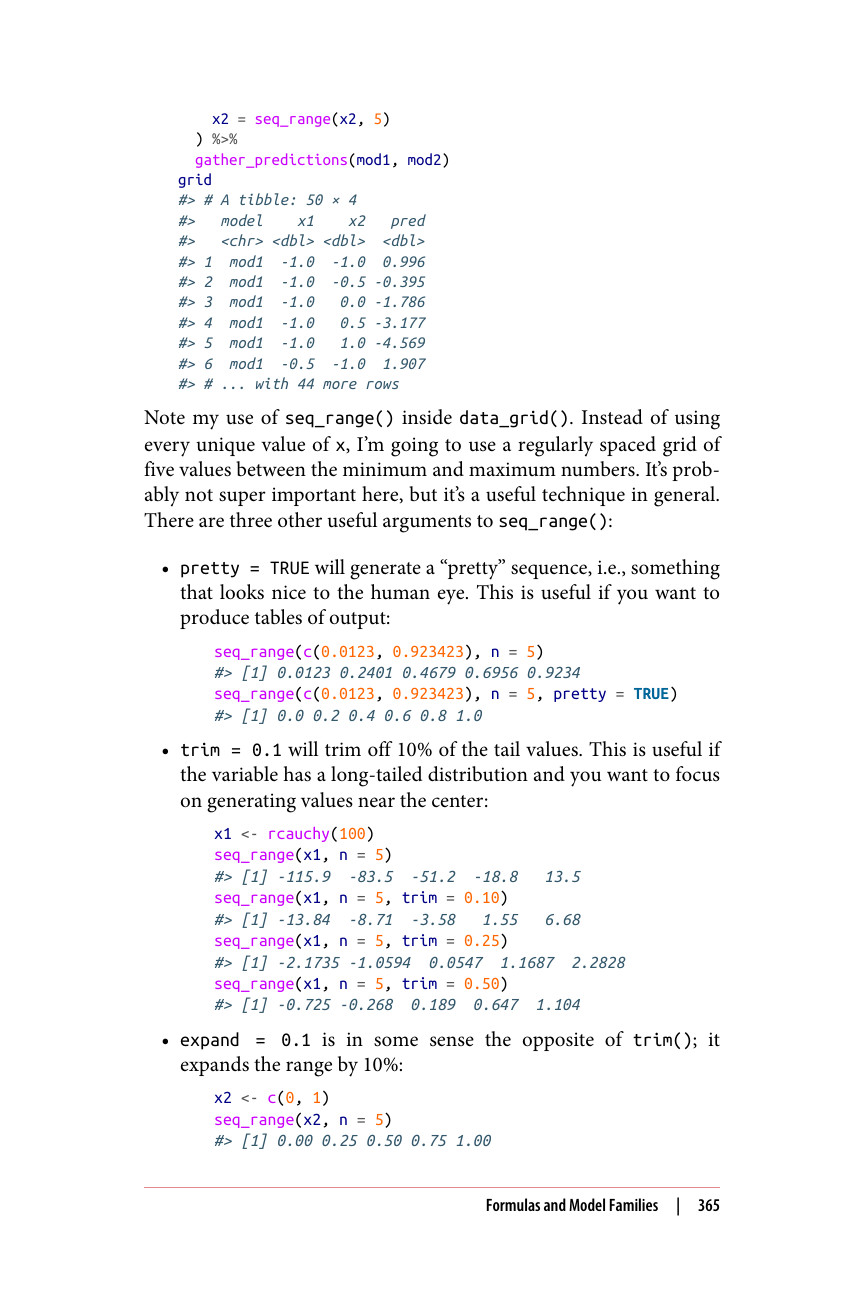
x2 = seq_range(x2, 5) ) %>% gather_predictions(mod1, mod2) grid #> # 一个 tibble:50 × 4 #> model x1 x2 pred #>
注意我在 data_grid() 中使用了 seq_range()。我没有使用 x 的每个唯一值,而是在最小值和最大值之间使用了一个由五个值组成的等间距网格。这在这里可能不是特别重要,但总体上是一个有用的技巧。seq_range() 还有另外三个有用的参数:
seq_range(c(0.0123, 0.923423), n = 5) #> [1] 0.0123 0.2401 0.4679 0.6956 0.9234 seq_range(c(0.0123, 0.923423), n = 5, pretty = TRUE) #> [1] 0.0 0.2 0.4 0.6 0.8 1.0
x1 <- rcauchy(100) seq_range(x1, n = 5) #> [1] -115.9 -83.5 -51.2 -18.8 13.5 seq_range(x1, n = 5, trim = 0.10) #> [1] -13.84 -8.71 -3.58 1.55 6.68 seq_range(x1, n = 5, trim = 0.25) #> [1] -2.1735 -1.0594 0.0547 1.1687 2.2828 seq_range(x1, n = 5, trim = 0.50) #> [1] -0.725 -0.268 0.189 0.647 1.104
x2 <- c(0, 1) seq_range(x2, n = 5) #> [1] 0.00 0.25 0.50 0.75 1.00