English · PDF 259
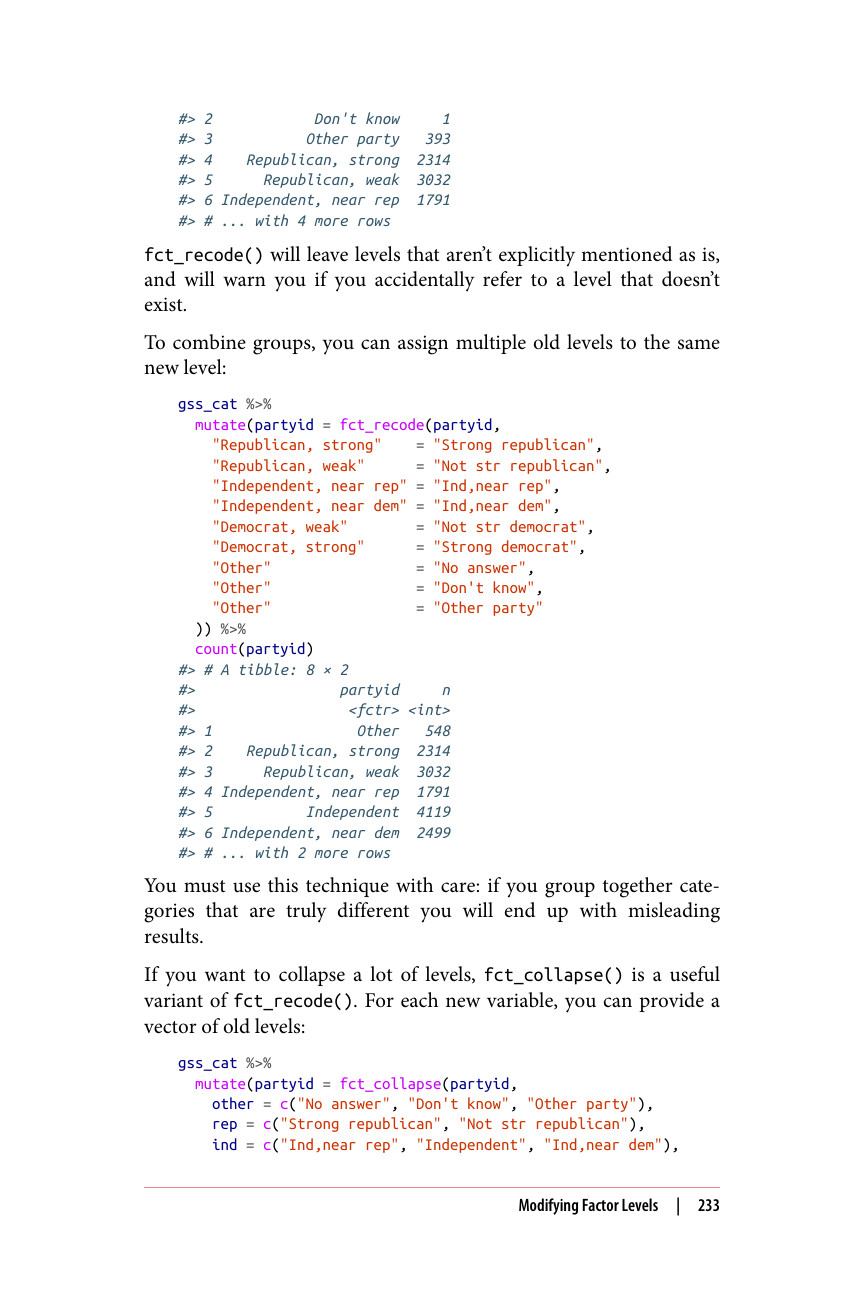
#> 2 不知道 1 #> 3 其他党派 393 #> 4 共和党,坚定 2314 #> 5 共和党,不坚定 3032 #> 6 独立人士,倾向共和党 1791 #> # ... 还有 4 行
fct_recode() 会保留未明确提及的水平不变,并且如果你不小心引用了不存在的水平,它会发出警告。
要合并分组,你可以将多个旧水平赋值给同一个新水平:
gss_cat %>% mutate(partyid = fct_recode(partyid, "共和党,坚定" = "Strong republican", "共和党,不坚定" = "Not str republican", "独立人士,倾向共和党" = "Ind,near rep", "独立人士,倾向民主党" = "Ind,near dem", "民主党,不坚定" = "Not str democrat", "民主党,坚定" = "Strong democrat", "其他" = "No answer", "其他" = "Don't know", "其他" = "Other party" )) %>% count(partyid) #> # 一个 tibble:8 × 2 #> partyid n #>
使用这种技术时必须小心:如果你把真正不同的类别归为一组,最终会得到误导性的结果。
如果你想合并很多水平,fct_collapse() 是 fct_recode() 的一个实用变体。对于每个新变量,你可以提供一个旧水平的向量:
gss_cat %>% mutate(partyid = fct_collapse(partyid, other = c("No answer", "Don't know", "Other party"), rep = c("Strong republican", "Not str republican"), ind = c("Ind,near rep", "Independent", "Ind,near dem"),