English · PDF 235
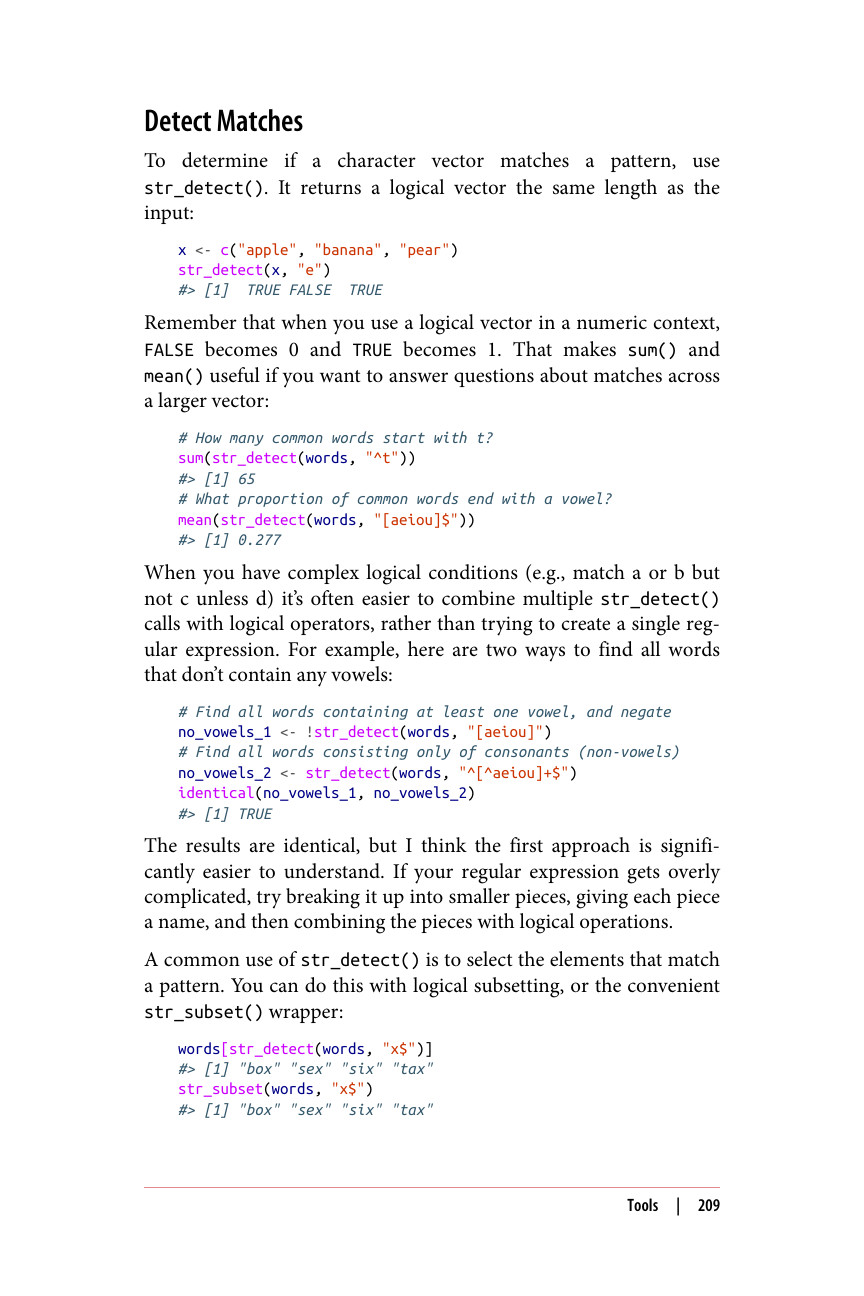
要判断一个字符向量是否匹配某个模式,可以使用 str_detect()。它返回一个与输入等长的逻辑向量:
x <- c("apple", "banana", "pear") str_detect(x, "e") #> [1] TRUE FALSE TRUE
请记住,当你在数值上下文中使用逻辑向量时,FALSE 会变成 0,TRUE 会变成 1。因此,如果你想回答关于更大向量中匹配情况的问题,sum() 和 mean() 会很有用:
# 有多少个常用词以 t 开头? sum(str_detect(words, "^t")) #> [1] 65 # 有多大比例的常用词以元音结尾? mean(str_detect(words, "[aeiou]$")) #> [1] 0.277
当你遇到复杂的逻辑条件(例如,匹配 a 或 b 但不匹配 c,除非 d)时,通常更简单的做法是用逻辑运算符组合多个 str_detect() 调用,而不是试图创建一个单一的正则表达式。例如,下面是找出所有不含元音的单词的两种方法:
# 找出所有至少包含一个元音的单词,然后取反 no_vowels_1 <- !str_detect(words, "[aeiou]") # 找出所有仅由辅音(非元音)组成的单词 no_vowels_2 <- str_detect(words, "^[^aeiou]+$") identical(no_vowels_1, no_vowels_2) #> [1] TRUE
两种方法的结果完全相同,但我认为第一种方法明显更容易理解。如果你的正则表达式变得过于复杂,可以尝试把它拆分成更小的部分,给每个部分起个名字,然后再用逻辑运算把它们组合起来。
str_detect() 的一个常见用途是筛选出匹配某个模式的元素。你可以使用逻辑子集选取,也可以使用便捷的 str_subset() 封装函数:
words[str_detect(words, "x$")] #> [1] "box" "sex" "six" "tax" str_subset(words, "x$") #> [1] "box" "sex" "six" "tax"