English · PDF 165
对于较大的文件,这些默认设置并不总是有效。有两个基本问题:
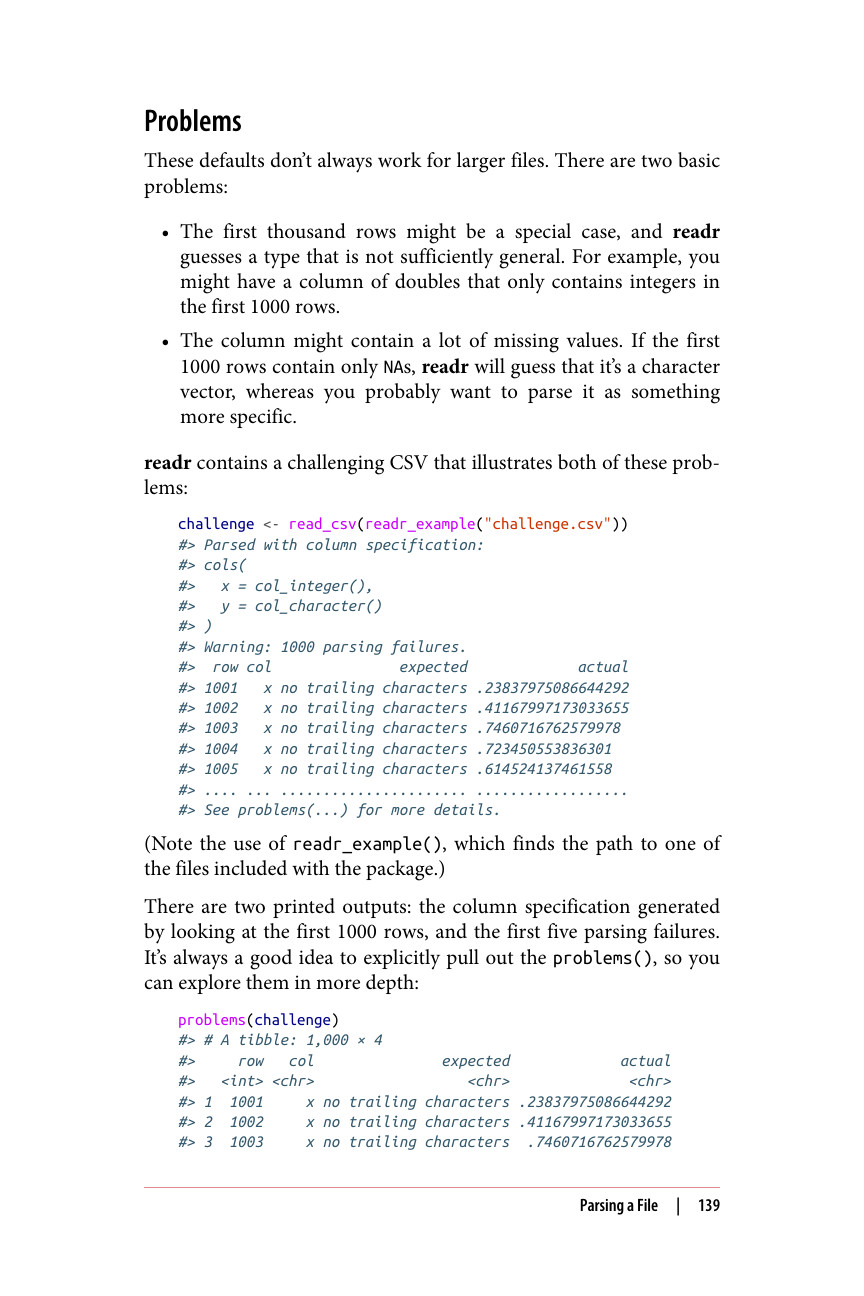
readr 包含一个具有挑战性的 CSV 文件,它同时展示了这两个问题:
challenge <- read_csv(readr_example("challenge.csv")) #> 使用列规范进行解析: #> cols( #> x = col_integer(), #> y = col_character() #> ) #> 警告:1000 个解析失败。 #> 行 列 期望 实际 #> 1001 x 无尾随字符 .23837975086644292 #> 1002 x 无尾随字符 .41167997173033655 #> 1003 x 无尾随字符 .7460716762579978 #> 1004 x 无尾随字符 .723450553836301 #> 1005 x 无尾随字符 .614524137461558 #> .... ... ...................... .................. #> 详情请参见 problems(...)
(注意这里使用了 readr_example(),它可以找到包中附带文件之一的路径。)
这里打印了两个输出:通过查看前 1000 行生成的列规范,以及前五个解析失败。显式地提取出 problems() 总是一个好主意,这样你可以更深入地探索它们:
problems(challenge) #> # 一个 tibble:1,000 × 4 #> 行 列 期望 实际 #>