English · PDF 84
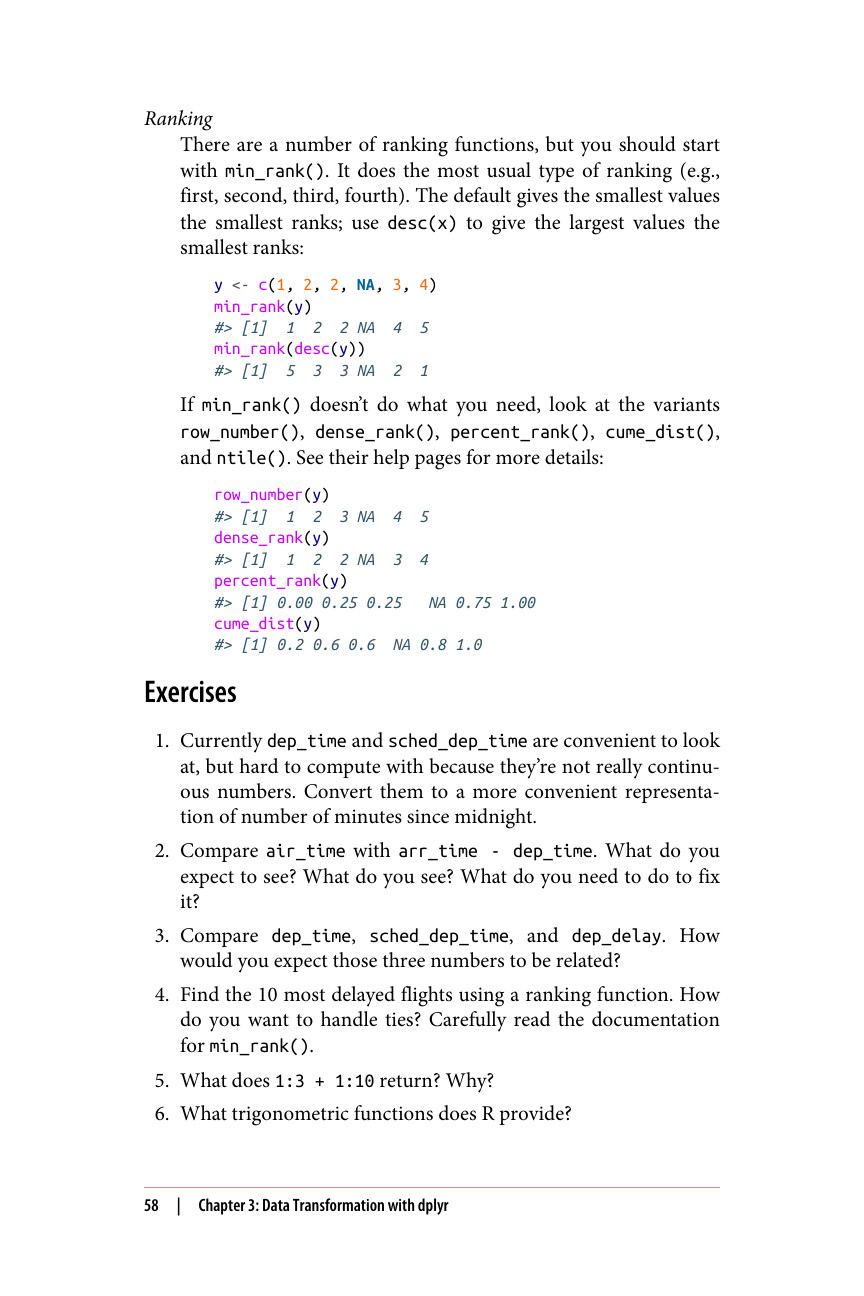
排序函数有很多种,但你应该从 min_rank() 开始。它执行最常见的排序类型(例如,第一、第二、第三、第四)。默认情况下,最小的值获得最小的排名;使用 desc(x) 可以让最大的值获得最小的排名:
y <- c(1, 2, 2, NA, 3, 4) min_rank(y) #> [1] 1 2 2 NA 4 5 min_rank(desc(y)) #> [1] 5 3 3 NA 2 1
如果 min_rank() 不能满足你的需求,可以看看这些变体:row_number()、dense_rank()、percent_rank()、cume_dist() 和 ntile()。详情请参阅它们的帮助页面:
row_number(y) #> [1] 1 2 3 NA 4 5 dense_rank(y) #> [1] 1 2 2 NA 3 4 percent_rank(y) #> [1] 0.00 0.25 0.25 NA 0.75 1.00 cume_dist(y) #> [1] 0.2 0.6 0.6 NA 0.8 1.0